C++11 列表初始化、移动语义与 lambda 表达式
C++11
1. 列表初始化
列表初始化就是用{}来初始化
其实列表初始化在 C 语言里面就有了,比如数组,和结构体.
1 | int a[] = { 1, 2 , 3, 4 ,5}; |
在 C++ 98 里面呢, 自定义类型里面的构造又支持了单参数的隐式类型转换,当然,不止一个参数也行,但是其它参数要有缺省值。
还有要注意的一点就是 C++ 98 里面实现单参数的隐式类型转换的时候,可以不写{},
1 | Date d2 = 2026; |
这个实现的原理就是先走一个构造,构造一个临时对象,然后再走拷贝构造。编译器还会再做优化,优化成一步构造之类的。
C++ 11 里面原理是一样的,只是构造支持了多参数的隐式类型转换。
怎么验证呢?我们说临时对象具有常性,直接引用的话引用不了,要加上const ;
1 | const Date& d3 = { 2026 , 3 , 23}; |
那么,C++ 11 里面加入的这个 列表初始化的目的是什么呢?就是为了一个统一,就是让所有的类型都可以用这一种初始化方式。
比如,内置类型可以用,自定义类型也可以用,
1 | int x = {2}; |
C++ 11 里面,其实也可以把 = 省略,
1 | int x = {2}; |
这里要注意的是,只有列表初始化,可以不写等号, C++ 98 里面还是要乖乖写等号的。
引入这个列表初始化,其实效率上是没有什么区别的,只是语法的不同。因为最后都会翻译成汇编指令,这个指令是一样的。那为什么要引入呢?因为有些情况下会非常方便,比如我们再使用匿名对象或者有名对象的时候,用列表初始化会更加的方便,连类名也不用写了。
1 | vector<Date> v; |
1.1 C++11 里面的 std::initializer_list
上述的列表初始化已经非常方便了,但是在一些情况下,还是有一些不方便,比如初始化容器。比如说,现在要初始化一个 vector
1 | vector<int> v1 = { 1 , 2 , 3}; |
我们可能就要写多个构造函数来支持,因为这两个的参数不一样多嘛,而且,我也不确定到底要用多少个。
所以,这个时候,C++ 11 库里面就有一个叫 initalizer_list的类模板,
1 | auto il = { 1 , 2 , 3 }; // initalizer_list<int> |
这个类模板本质上就是一个数组,把{}里面的数据拷贝到一个数组空间,然后一个指针指向开始,一个指针指向结尾,支持迭代器,所以它的迭代器就是原生指针,支持范围for。
C++ 11 里面 每个容器就多了一个initalizer_list 的构造函数。也就支持任意多个值构成的{x1,x2,x3…} 进行初始化。那么底层是怎么办到的呢?刚才提到过,
initalizer_list支持迭代器遍历,那么范围for遍历一遍,然后把数据一个个push_back()一下就好了,
1 | template<class T> |
另外,容器的赋值也支持initializer_list的版本
1 | vector& operator= (initializer_list<value_type> il); |
关于 initializer_list 其实底层是一个数组,我们可以验证一下:
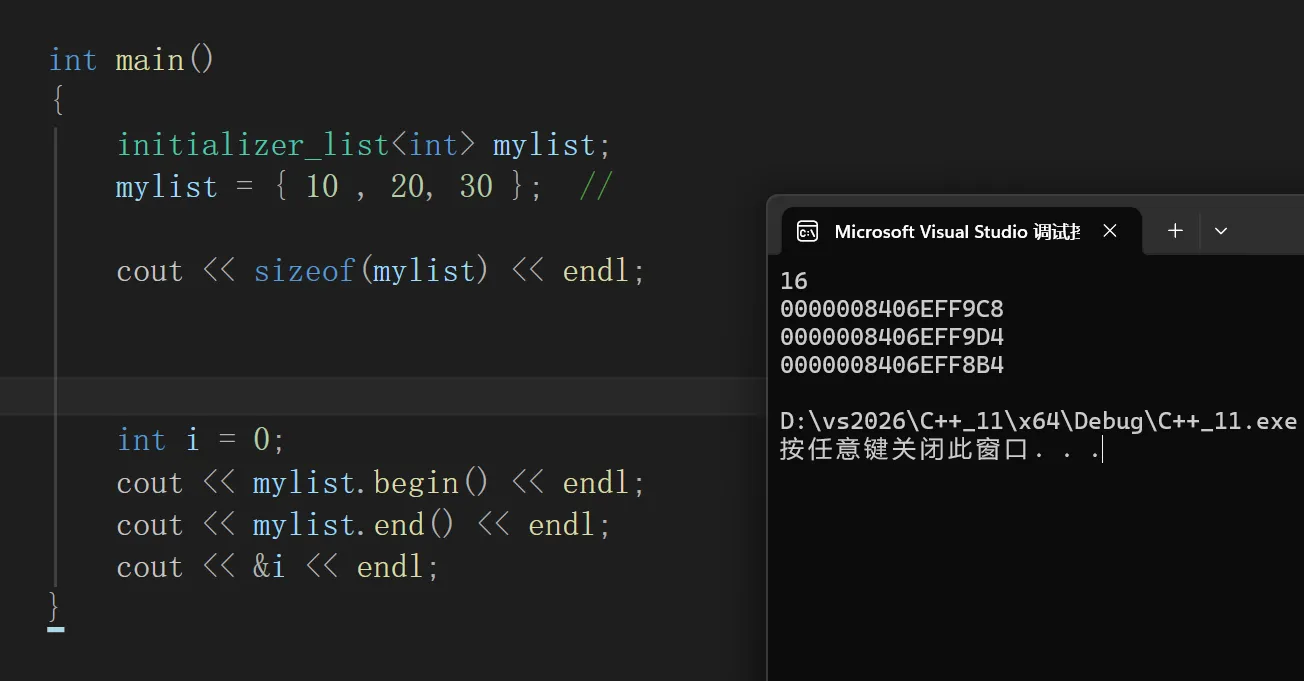
如图,begin() 和 end() 返回的是指向这个数组的左闭右开的指针,开在栈上的,因为和 i 的地址非常接近。
{}列表中可以有任意多个值,大那是写法不同的话,实际在语义上是有不同,下面两种情况就是了,
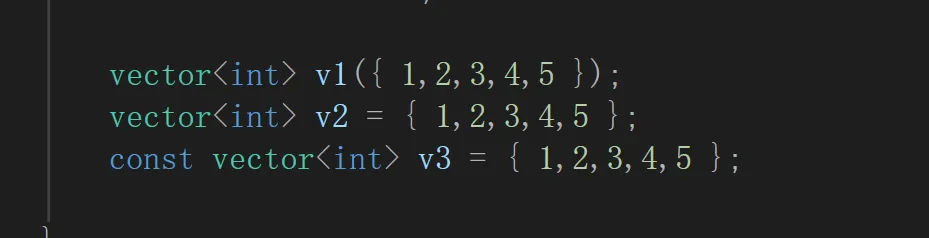
第一个是直接构造,第二个是走隐式类型转换,先构造一个临时对象,在拷贝构造,当然,编译器会优化为直接构造。
当然,在初始化的时候,列表初始化和initializer_list也是可以一起用的,比如:
1 | map<pair<string,string>> mp = {{"排序", "sort"} , {"字符串","string"}, {"你好", "hello"} }; |
这里就是用列表初始化,初始化pair,然后用initializer_list来构造一个map;
2. 右值引用和移动构造
在C++98 中,就有了引用的语法,然后 C++ 11 中,又加入了右值引用的语法。但是无论是左值引用还是右值引用,其实都是取别名。
2.1 左值和右值
左值是一个表示数据的表达式,一般是持久状态,储存在内存中,我们可以取它的地址,这是主要的区分左值和右值的一个特点。左值可以出现在等号左边,也可以出现在等号右边。 定义时, const 修饰的左值,不能修改,但是可以取地址,所以,不是不能修改的值就是右值,而是要看这个值能不能取地址。
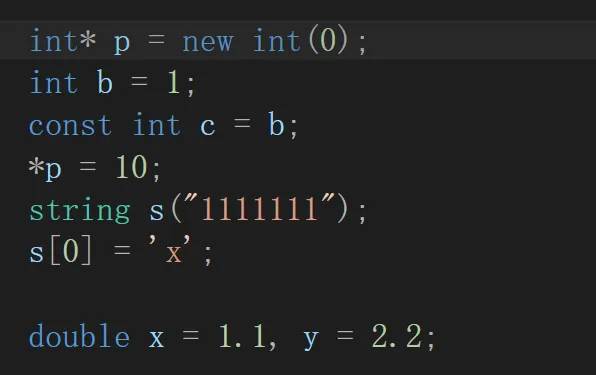
这些都是常见的左值。
右值就是一些具有常性的值,要么是字面量常量,要么是临时对象。右值可以出现在等号的右边,但是不能出现在左边,因为不能修改嘛。右值是不能取地址的。一般来说,临时对象放在寄存器里面,稍大一些的临时对象放到缓存中。所以,右值是不能取地址的。
有一个有意思的点在于,左值的英文叫 lvalue 右值的英文符号叫 rvalue 。传统认为,l 是 left, r 是 right;现代 c++ 里面lvalue被解释为 loactor value的缩写, 意为储存在内训中,有明确地址的,可以取地址的对象, 而 rvalue 意为 read value 意思是可以提供值,但是不能取地址的变量。 包括上文中提到的临时对象,字面量常量,匿名对象,储存在寄存器中的对象。
这里验证的时候注意一个点,cout 是不能直接输出地址的, 要强转成一个(void*), 因为cout 会把地址认为是一个16进制的整数,然后输出出来,还是有点区别的,比如前导零没了。
2.2 左值引用和右值引用
左值引用和右值引用,顾名思义就是左值的引用和右值的引用
1 | int& a = b; |
第一个就是左值引用,第二个就是右值引用,右值引用形式上就是比左值引用过一个&。
左值和右值引用的特点如下:
1.左值引用不能直接引用右值,但是const 左值可以引用右值,其实这里还和权限放大有关系
2.右值引用不能直接引用左值,但是右值引用可以引用move(左值),
这个move是库里面的一个函数模板,本质就是强转,涉及到引用折叠,所以下后期细讲
3.还需要注意的一个点就是,变量表达式都是左值属性,这就意味着右值引用自身属性是个左值。
4.左值引用和右值引用都是取别名,不开空间,底层都是指针实现的,没什么区别。但是从语法层面来讲的话区别可就大了,所以,讲语法的时候只好不要研究底层。
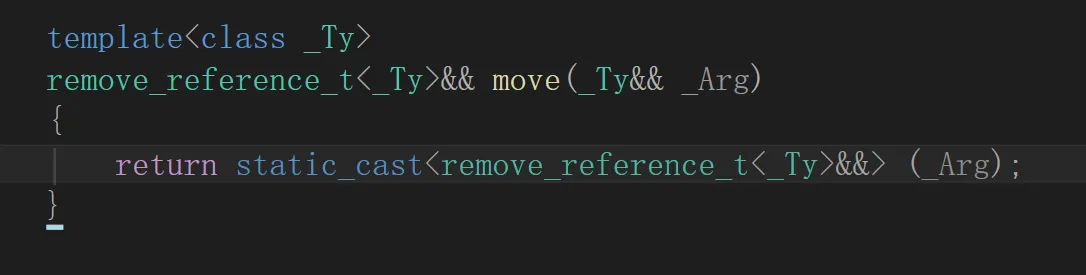
如图就是move的底层实现,static_cast 本质就是强转。
下面,我们来演示一些上述特性:
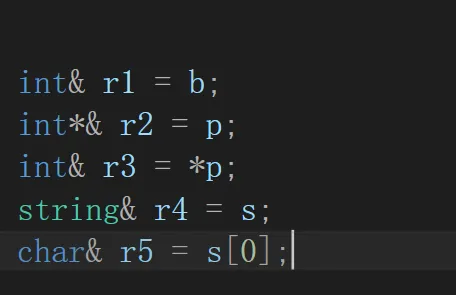
这些就是正常的给左值取别名,是左值引用。
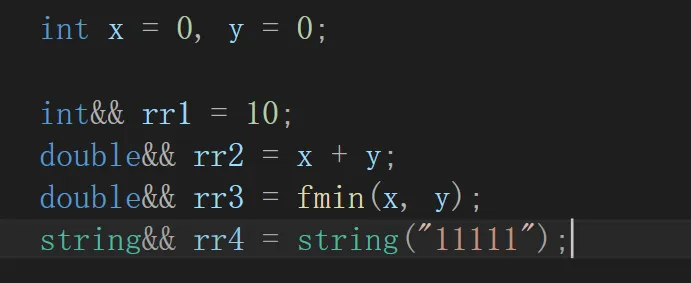
而这些就是给右值取别名,是右值引用,包括字面量常量,传值返回,匿名对象,还有我们说表达式运算的结果存在临时对象里面,然后再拷贝过去。
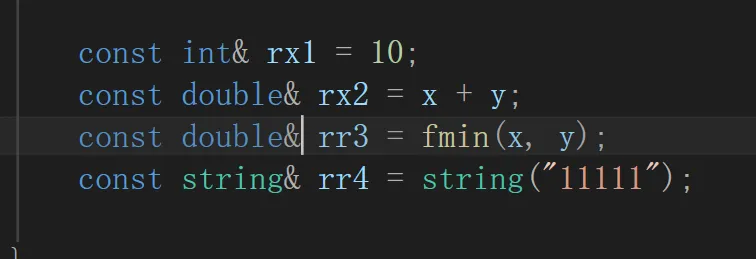
这里就是之前提到的,左值引用不能直接引用右值,但是可以const 左值可以引用右值
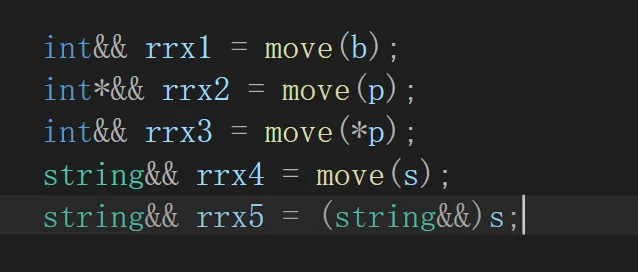
这里就是,右值引用不能直接引用左值,但是可以引用move之后的左值,当然,最后一句也就验证了强转也可以,move底层就是强转。 所以, move以后的左值,比如这个 b 是左值还是右值? 答案是左值,强转嘛,只是产生一个临时对象,本行使用销毁,对 b 没有影响, C语言里也是这样,没变过。
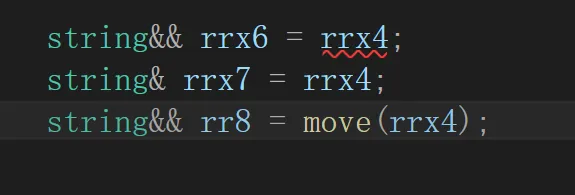
这里就是之前提到过的容易混淆的一点,就是,右值引用本身是左值,不难直接被右值引用引用,除非move一下。
2.3 引用延长生命周期
右值引用有什么作用呢?第一个作用就是可以延长被引用对象的生命周期。我们知道,临时对象,匿名对象的生命周期都在这一行里面,但是右值引用之后,生命周期就和右值引用的生命周期一样了。但是需要注意的一点是这个延长生命周期,只在当前作用域里面,换句话说就是,如果这个函数的栈帧销毁了,它该销毁还是该销毁。
下面举例:
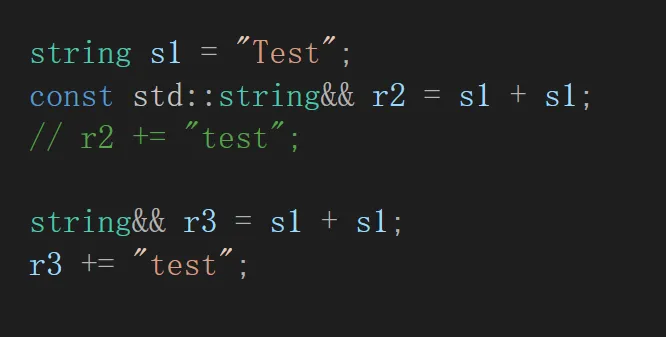
如图,s1 + s1 这个表达式的结果,可以通过const 左值引用延长生命周期,也可以通过右值引用延长生命周期。
但是,要注意到的很重要的一点,就是 const 左值引用不可修改,而 右值引用我们说它的属性是左值,所以,可以通过右值引用修改。
2.4 左值和右值的参数匹配
在C++ 98 里面,我们给自定义类写拷贝构造的时候,用的是 const 左值的参数,而 const 左值的参数,左值和右值都能匹配。这也是为什么要求要const,要不然有些临时对象,比如函数传值返回的时候,不加const会出问题。
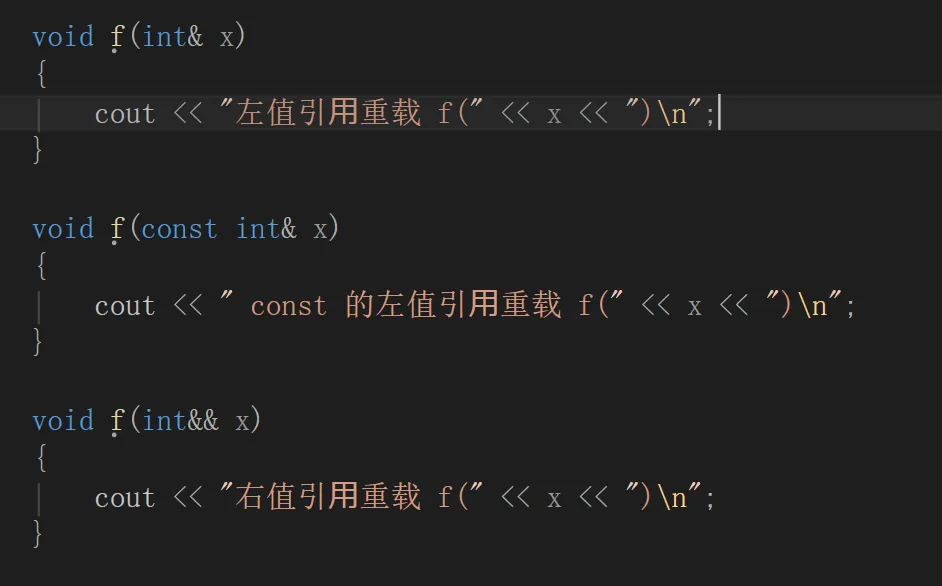
C++11 以后,拷贝构造可以分别重载左值引用,const左值引用,右值引用。调用函数的时候,实参会自动挑一个最合适的拷贝构造使用。比如,传普通左值,会调左值的构造,传const左值,会调const左值引用,传右值会调右值引用。
之前提到过,右值引用的属性是左值,这也是有原因的,马上就解释
2.5 右值引用和移动语义的使用
2.5.1 左值引用的使用场景
在讲述之前,我们来思考一下 C++ 98 为什么要加入引用。有可以修改实参和修改返回对象的价值,但是很大一部分原因是为了减少拷贝,因为我们知道自定义对象传参,赋值等等的时候都需要调拷贝构造,而如果这个自定义类非常复杂,那么它深拷贝的代价就会非常大,所以,为了解决这种情况,C++ 98 里面加入了左值引用。
左值引用的意义是相当大的,有了左值引用,像函数传值传参的时候,就可以传引用,从而减少拷贝。但是,左值引用也还有没有解决的问题,那就是传值返回。比如 addstring 函数。
1 | class Solution { |
我们注意到,这个addstring函数是传值返回的,传引用返回行不行?当然不行,函数调用结束后栈帧就销毁了,这个函数计算出来的str也销毁了,传引用返回的话,引用会变成野引用,这是非常不对的。
要解决这个传值返回需要拷贝的问题,其实,有三个人群在解决这个问题,一个就是程序员,一个是编译器,还有就是C++标准委员会。
我们一个一个来看,程序员一开始会怎么做呢?一般会这样写:
1 | string ret; |
我们可以看到,程序员会给这个函数加一个参数,这个参数就是返回值,然后传到函数里面,运算完的结果直接放到这个返回值里面。当然,要传ret的引用过去,不然又错了。
那么编译器会怎么办呢?之前在类和对象里面,我们也讲到过,这里再来明确一次。现在主流的编译器就是微软的编译器,还有GCC/G++,当然,这些编译器优化的情况大同小异。
首先,在编译器完全不优化的时候,(这个可以用g++,然后编译的时候这样写 g++ test.cpp -fno-elide-
constructors 选项来关闭编译器优化)。
还是以上面的addstring来举例, 完全不优化的情况下,传值返回,先调一次拷贝构造,用str构造一个临时对象,然后再调一次拷贝构造来构造ret。
第一代编译器的优化是这样的,编译器会节省一次拷贝构造,直接用str来拷贝构造ret。
而第二代编译器的优化就非常激进了,比如说vs2019的release, 或者 vs2022的debug。 在一代优化的基础上,我们来看这个流程,首先,构造str,然后计算结果完成后,str拷贝构造ret。总共要经历一次构造,和一次拷贝构造,二代优化就只需要一次构造了,也就是说, 编译器直接把 str 看成了 ret 的引用 , 合二为一或者说合三为一了,挺离谱的。
总结一下,上述情况都是在只有拷贝构造的情况的下的解决办法。
2.5.2 右值引用和移动语义(移动构造,移动赋值)
那么C++标准委员会是怎么解决这个事情的呢?就是搞出来右值引用和移动语义。什么是移动构造呢》就是参数是右值引用的构造函数的重载。为什么右值引用和移动构造可以解决这个问题呢? 要搞清楚这样原因,我们首先要看一下移动构造的原理。
我们之前提到过右值,右值就是一些临时对象,换句话说,丢了也就丢了,意义不大,我们正好就可以利用这一点,来进行操作,来看下面的移动构造:
1 | mtstring(string&& s) |
我们看到,移动构造就是直接调用了一次swap,把右值的资源直接给换到了新的对象里面,换句话说,这个本质上就是一种资源的”掠夺” 。 这个交换的消耗怎么样?非常的小,因为,我们知道string的底层就是一个数组,交换只需要交换一下指向数组的指针和用来维护这个数组的信息就好了,这个消耗可以说少了不是一点点,而是把需要深拷贝的销毁变成了几次赋值就好了。 有没有什么副作用呢?没有的,因为交换的是一个右值,临时对象或者匿名对象使用一次后生命周期就到了,该销毁的销毁,不会有影响。 但也仍需注意,因为移动构造经过交换后,把右值给置空了,如果,发生交换的是一个move之后的左值,这个左值也会被置空,这点一定要注意。
好了,有了移动构造,那么这里的传值返回不可避免的需要拷贝的事情,就得到了完美的解决,只需给这个自定义类里面重载上一个移动构造就好了,再结合上之前说的,参数自动匹配,这样在使用层面还是和之前一样,但是底层的效率层面已经今非昔比了。
有了移动构造,编译器如何优化呢?其实,优化不优化已经意义不大了,因为这个移动构造已经几乎跟没有消耗差不多了。
首先,什么都不优化的情况,会走两次移动构造,来构造ret;
编译器的第一代优化,是把两次移动构造优化成一次。
第二代优化也还是激进地合三为一,直接构造,把str看成是ret的别名。
移动赋值的使用也是同理。
1 | My:: string ret; |
在只有拷贝构造和拷贝赋值的时候,编译器不优化的情况就是走一次拷贝构造一个临时对象,临时对像拷贝赋值给ret。
优化的时候就是把str看成是临时对象的别名,也就是说 str 是 这个临时对象的别名,底层用指针实现,可以观察到。直接构造临时对象,然后再拷贝赋值给ret
有移动构造和移动赋值的时候。
编译器不优化的情况就是走一次移动构造一个临时对象,临时对像移动赋值给ret。
优化的时候就是把str看成是临时对象的别名,也就是说 str 是 这个临时对象的别名,底层用指针实现,可以观察到。直接构造临时对象,然后再移动赋值给ret。
2.5.3 右值引用和移动语义在传参中的提效
当我们查阅官方文档后,发现C++ 11 后,STL里面的容器的push和insert接口都增加了右值引用的版本。
这样的话,传左值调用拷贝系列来拷贝,传右值调用移动语义,因为移动语义的效率相比之下很高,所以,推荐在使用类似接口的时候传匿名对象。
其实这里还有emplace系列接口,但是这个又涉及到可变模板参数,引用折叠,这个后面再详细说明。
2.6 类型分类
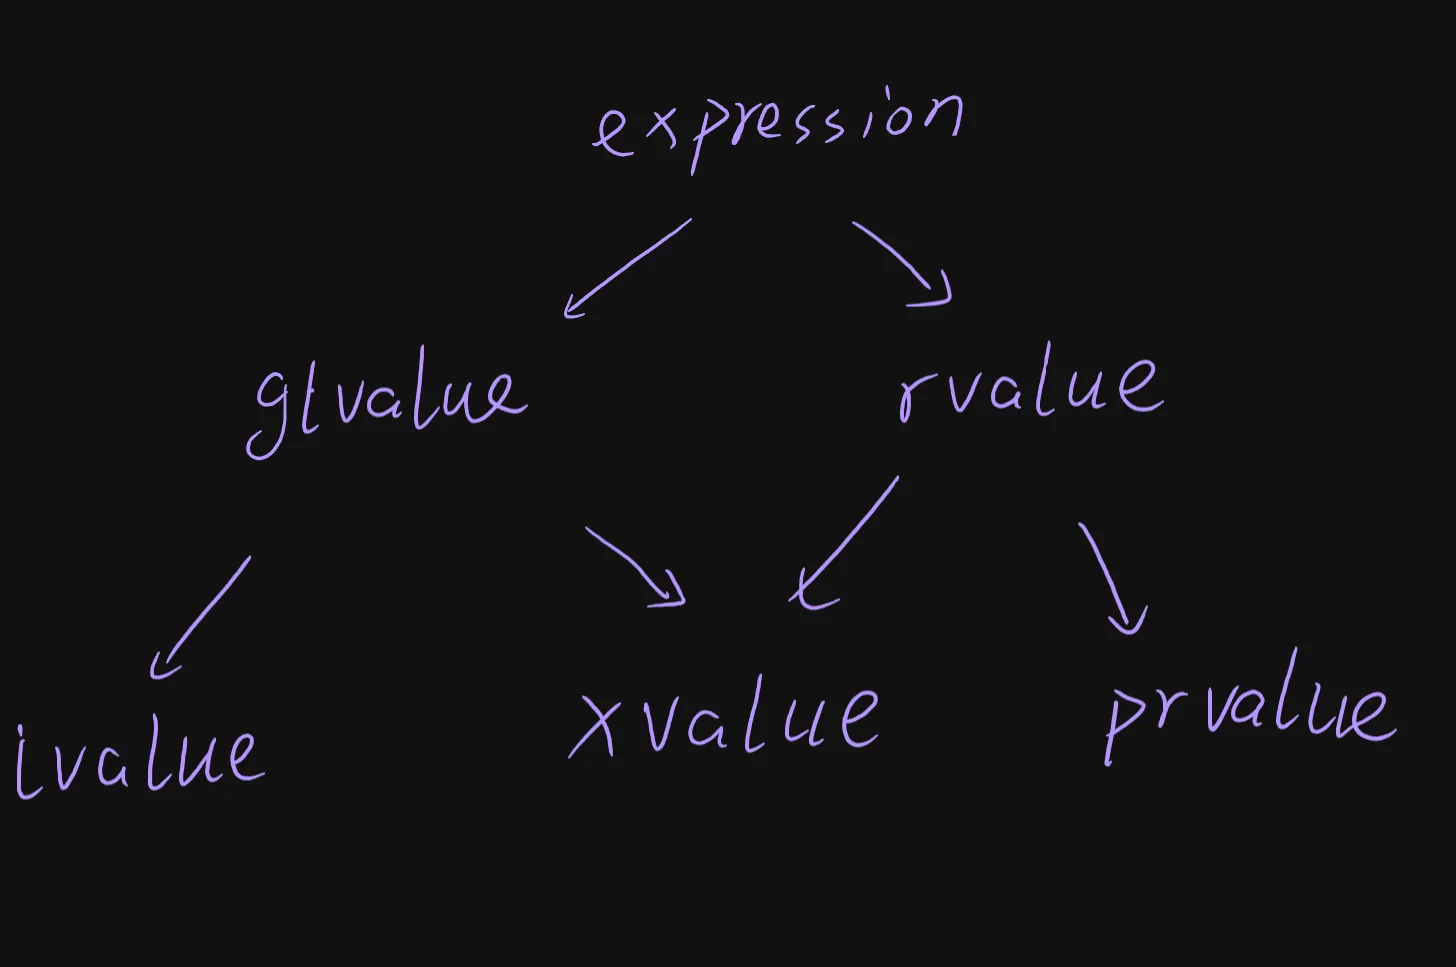
C++ 11 以后,对类型进行了进一步的划分,右值被划分为纯右值(prvalue)和将亡值(xvalue)。
纯右值指的是一些字面量常量,或者求值结果相当于字面值,或者是一个不具名字的临时对象。比如 42, nullpte
或者str.substr(1,2), str1 + str2 传值返回,或者是 a + b , a++等,C++11 中的纯右值,等价于C++98中的右值。
将亡值指的是强制类型转换转成右值的值,比如move(x), 或者 static_cast(x)。
泛左值(glvalue),指的是左值和将亡值。
看着挺迷糊的,具体类型关系参考下图:
2.7 引用折叠
C++ 11 里面不能直接定义引用的引用,这样会报错,比如
1 | int& && r = i; |
这样就是错误的。但是,通过模板或者typedef操作,可以构成引用的引用。
比如:
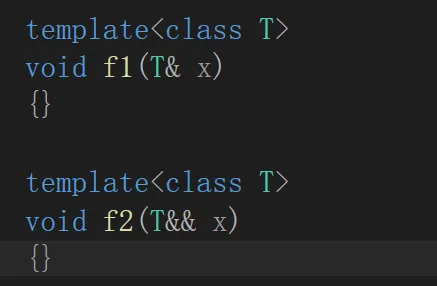
可以看到,如果这里的模板参数实例化出来一个 引用的话,那么就会出现引用的引用。于是,就会发生引用折叠。
比如,看f1 ,如果 T 是左值引用,x 是左值引用, 如果 T 是右值引用, x 还是左值引用。
再看 f2 ,如果 T 是左值引用, x 还是右值引用, 如果 T 是右值引用, x 就是右值引用了。 (加上const也遵循规律)
这就是引用折叠现象。总结就是,只有 T 是右值引用,而且 是 f2 这种右值引用的写法的时候,才会折叠成右值引用。
typedef同理,两个都是右值引用,合体之后才是右值引用。
根据这样引用折叠,我们可以设计出一类特殊的模板,就想f2这种,有的地方也叫做万能模板:
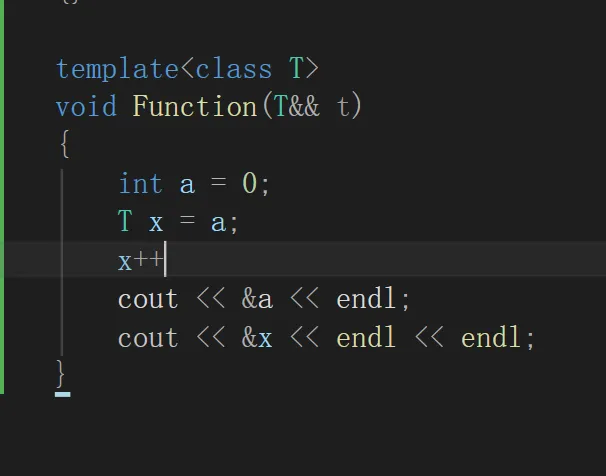
如果,T 传过来是左值,那么实例化的时候,就会实例化出来左值引用。如果传过来的是右值,那么实例化出来就是右值模板。
传什么实例化出来什么。
2.8 完美转发
结合上述的万能模板参数,会出现一个问题,就是,如果 T 实例化出来的是右值引用,也就是说 x 是右值引用。如果,这个模板里面又套了一个万能模板的话,如图:
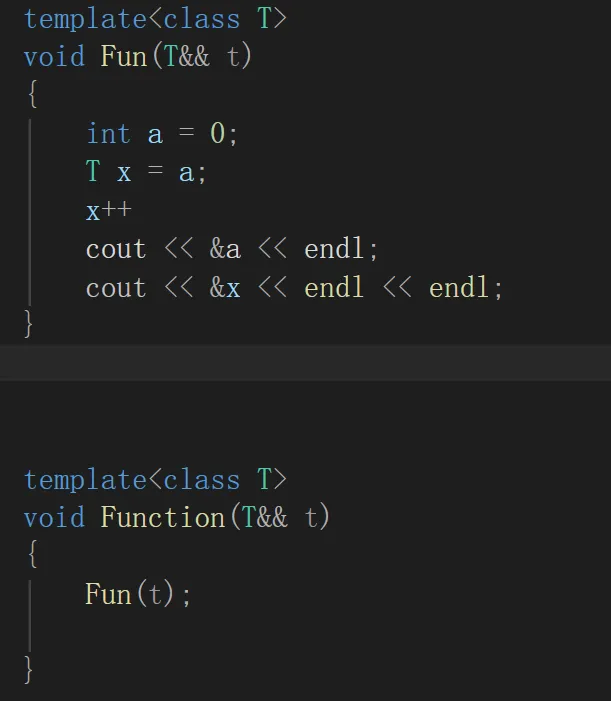
之前我们提到过,右值引用自身的属性是左值,也就是说,我要继续使用下一个万能模板的时候,用这个 t 只能实例化出一个左值引用,而不能实例化出右值引用。那么这个时候要怎么解决呢?就需要完美转发。
完美转发是一个函数模板,本质上就是进行了一次强制类型转换
1 | template <class T> T&& forward (typename remove_reference<T>::type& |
我们只需要这样写:
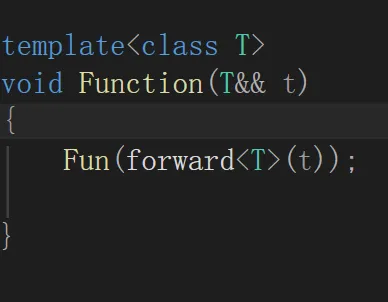
就可以把这个 t 继续当作右值往下传。
3. 可变参数模板
3.1 C++11 基本语法和原理
C++ 11 支持可变模板参数,也就是说之前棵变参数数量的函数模板和类模板。可变的那部分参数称为参数包,一共有两种参数包,一种模板参数包,表示 0 个或者多个模板参数。 还有一种是函数参数包, 表示 0 个或者多个函数参数。
1 | template<class... Args> void Func(Args... args) {} |
我们用一个省略号来指出这个参数的位置是个包,模板参数的时候 … 放在class或者typename后面,在函数里面,放在类型的后面。参数包依然是支持引用折叠的。
可变模板参数的原理和模板类似,同样可以实例化出不同的模板。与之前的固定的模板参数的模板不同,这里的参数是可变的,换句话说,这个比之前的模板要更加的泛型。
我们可以用 sizeof… 操作符来计算参数包中的参数个数。
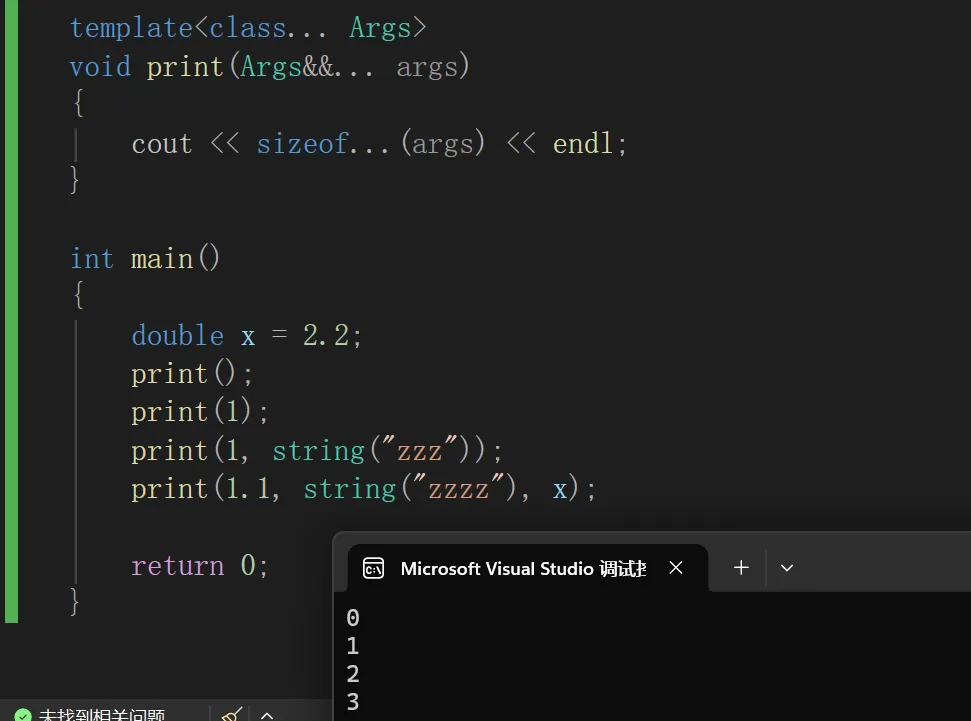
这里还有一个点注意一下,这个参数包在声明的时候,三个点是放在类型后,参数前的,但是用的时候要放在参数后面。
3.2 包扩展
其实,我们在使用函数参数包的时候,真正难受的不是去调用,麻烦的是底层怎么把这些参数都分离出来。不分离肯定不行,那么怎么把这些函数都分离出来呢?这个分离的过程就叫做包扩展。
首先,最容易想到的办法是当初数组用[]来访问,看起来很方便,但这个是根本不行的。我们可以用别的方式。
第一种方式如图:
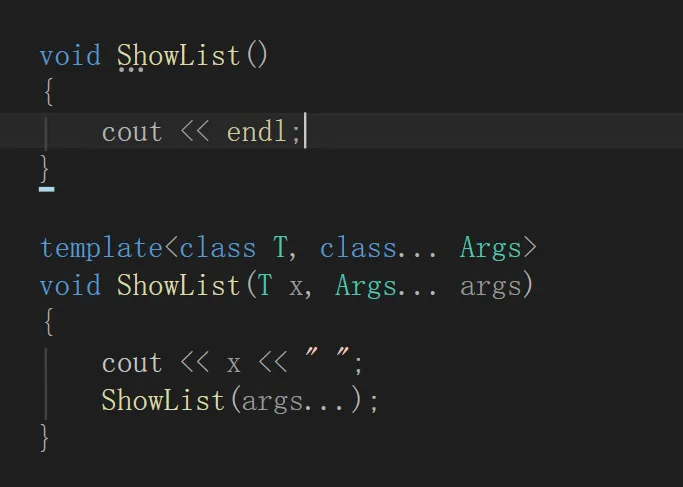
可以看到,定义了一个函数模板,其中包含了一个模板参数 T ,和 参数包。 看得出来这是一个递归调用,当我们用包扩展的时候,我们在传参的时候要在参数后面加上… 来触发包扩展。这个第一个模板参数,就相当于是把这个包里面的参数一个一个给剥离出来。需要注意的是,当这个函数包里面没有东西了,那么就会调用没有参数的这个函数,所以,要重载一个无参的函数。
那么他的底层是什么呢?刚才提到了递归,这里的递归和以往的递归有些不同,这里的递归是编译时递归。编译器,在编译的时候,递归推导实例化出不同参数的函数。如图:
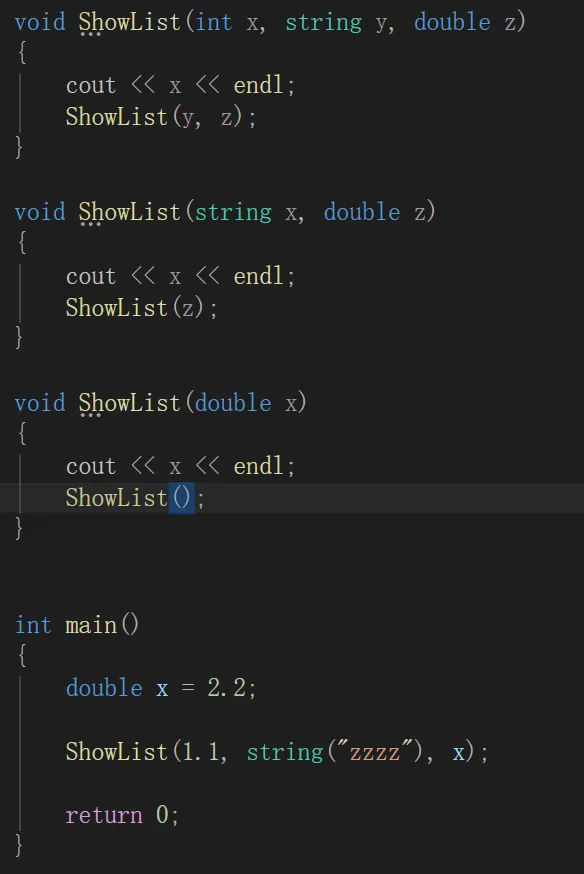
可以看到,编译时递归推导,其实就是实例化出这几个函数,从而完成包扩展。
包扩展还有一种玩法是什么呢?
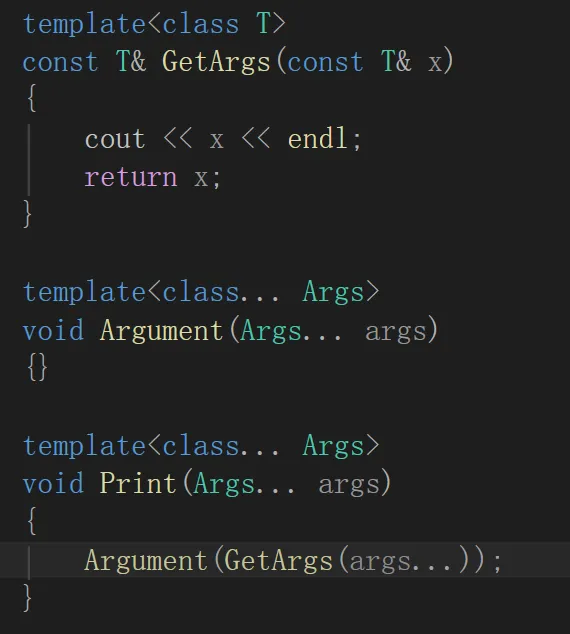
在使用Print函数的时候套了两层,一层是GetArgs函数,一层是Argument函数,可以看到,GetArgs函数的模板参数是一个,所以,他就是用来一个个地剥离参数包里面的参数的。而 Arguements函数参数是个参数包,也就是说,触发包扩展了以后,GetArgs函数的返回值,就变成了Arguements的参数,这个参数有几个都可以,换句话说就是GetArgs 调用几次都可以,也就可以很好地完成一个一个剥离参数包的参数的任务,而Arguement函数,函数体里面什么都不要写,因为他不需要干活,只需要提供这个环境就好。
换句话说,用第二种方法编译时递归推导出来就是这样一个:
1 | void Print(int x, string y, double z) |
或许有些不好理解,只能说,这个委员会大佬设计还是很有实力。
3.3 emplace 系列接口
之前提到的坑该填一填了, 在C++11 里面呢,STL中的容器增加了emplace系列接口,
1 | template <class... Args> void emplace_back (Args&&... args); |
1 | template <class... Args> iterator emplace (const_iterator position, |
emplace系列接口均为可变模板参数,功能上兼容 push和insert系列,也就是说push和insert系列的大部分用法,emplace系列都是支持的,emplace系列还有自己独特的用法。
这里先说结论,emplace系列整体来说比push和insert系列效率要高,因为涉及到了右值引用和移动语义嘛。
如果传左值,emplce_back和push_back都走拷贝构造,如果传右值都走移动构造,那么emplace_back到底哪里快呢?
1 |
|
来看这种情况,这里的push_back用的是列表初始化,所以要走的是构造 + 移动构造,而 emplace_back没有用列表初始化,而是直接用这个值来进行构造,为什么这么支持,因为可变模板参数,换句话说,这里的底层的构造函数也需要相应调整
但是,emplace_back有时就不支持,initializer_list来初始化,因为,emplace_back里面走了一个完美转发,还有,参数包,如果用initializer_list来初始化的话,就无法推导类型了。但是,直接不要{},传类型不就好了吗
接下来应该放一个演示的链表,我还没写,额,过后再补,嘻嘻。
4. 新的类功能
4.1 默认的移动构造和移动赋值
原来的C++类里面有六个默认成员函数。默认成员函数就是我们不显示写,编译器会自己生成。拿六个呢?构造,拷贝构造,赋值重载,析构,取地址重载,const取地址重载。主要的其实是前面四个。
在C++ 11 后,如果你没有显示地写移动构造且没有写拷贝构造,赋值重载,析构函数中的任意一个,编译器会自己生动生成一个默认构造,对于内置类型就是浅拷贝,对自定义类型就是看看这个自定义类型有没有移动构造,有就调,没有就调拷贝构造。
移动赋值也是同理,如果没有显示写移动赋值,且没有实现析构函数,拷贝构造,拷贝赋值重载中的任意一个,编译器会自动生成一个移动赋值。默认移动赋值,对内置类型浅拷贝,对自定义类型如果实现移动赋值就调,没有就调拷贝赋值。
为什么这个规则看起来很奇怪,为什么是三个函数中的一个显示实现就不生成,主要是因为这三个函数几乎是绑定的,因为需要深拷贝,所以,拷贝构造,赋值重载,析构都要才对,要不然就会出问题。而如果全是需要浅拷贝的内置类型,其实是不需要写的。
这时自动生成移动语义也更加合理和安全。
4.2 成员变量声明时给缺省值
这个之前提到过,类和对象篇里面有。 对了,《effective C++》中提到,在没有这个语法前,在类里面定义数组,常用enum
4.3 default 和 delete
default 就是可以让编译器自动生成默认成员函数,比方说,如果你显示实现了拷贝构造,移动构造就不会自己生成了,可以用default来强制让编译器自动生成.
1 | Parson(Person&& p) = default; |
如果能想要限制某些默认函数的⽣成,在C++98中,是该函数设置成private,并且只声明补丁已,这样只要其他⼈想要调⽤就会报错。在C++11中更简单,只需在该函数声明加上=delete即可,该语法指示编译器不生成对应函数的默认版本,称=delete修饰的函数为删除函数。
4.4 final 与 override
final 修饰的类不可被继承, override是强制让编译器检查子类的虚函数有没有复写成功,详细的之前也讲过,额,我还没赶出来,嘻嘻.
5. STL 中的变化
STL中新增了哈希表的新容器,unordered_map和unordered_set.
STL中也增加了新的接口,比如push和insert的移动语义重载,还有emplace系列接口,还要initalier_list,
还有一些cbegin(), cend()等迭代器.
还有容器范围for的遍历.
array 和 foward_list都是C++ 11 新增.
6. lambda
6.1 lambda 表达式语法
lambda表达式的本质是一个匿名的函数对象,注意,也是对象,和普通函数不同的是它可以定义在函数内部. lambda 表达式虽然是个函数对象,额,算了,直接说结论,lambda表达式底层还是仿函数,它类型名是lambda加上一串uuid.所以,我们在接受lambda表达式的时候,通常是用模板或者auto让编译器自己推导的.
lambda表达式的格式:
1 | [capture_list] (parameters) -> return type {function body} |
第一个方括号围起来的叫捕获列表,可以使lambda里面使用lambda外面的变量,我们最后说.
第二个括号和一般函数是一样的,是参数列表,这个是可以省略不写的,包括();
第三个是return type 这部分也可以省略,编译器会自己推导.
最后一个是函数体,与普通函数完全类似,可以有多行,但是不能省略
总结一句话就是两头不能省略,中间可以省略.

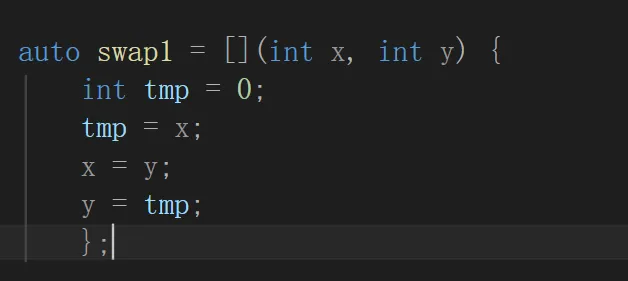
这就是lambda表达式的基本的语法. 递归.
6.2 捕捉列表
lambda表达式虽然定义在函数内部,但是,默认只能使用自己里面的参数,或者是传参进来的参数,如果想要使用这个作用域里面其它的参数的话,就要走捕捉列表.
第一种捕捉方式是是在捕捉列表显示地写,可以捕捉引用,或者捕捉变量,每个变量之间用 “ , “ 隔开.
1 | [x, y , &z] |
就是这样,这里也是有一个容易记混的点,就是这里的 &虽然放在变量前面,但是其实是引用的意思.
第二种捕捉方式是在捕捉列表中隐式捕捉,如果要值捕捉,那么就可以直接写一个 “=”, 要引用捕捉就可以直接写一个”&”.
lambda中用了哪些变量,编译器会自动捕捉那些变量.
1 | [= , &] |
第三种方式就是混合捕捉,既有显示捕捉,又有隐式捕捉. 当使用隐式捕捉的时候,隐式捕捉的符号必须在第一个,如果已经隐式值捕捉了,后面就不能再显示值捕捉了,引用捕捉同理.
还有需要注意的一点是,如果lambda定义在函数局部域里面,只能捕捉它之前声明或者定义的变量,这是一般的查找规则,之前类域是特殊的,需要在类域里面查找的会就可以上下查找.
全局变量和静态变量不能捕捉,也不需要捕捉. lamada表达式可以直接使用, 如果 lambda表达式定义在全局,捕捉列表必须为空.
默认情况下,lambda表达式传值捕捉过来的对象是被const修饰的不可以修改,可以在参数列表的后面加上mutable,这样可以取消常性,但是即使修改了,修改的也是形参对象,不影响实参.使用该修饰符以后,参数列表不可为空.
还有,lambda表达式不可以递归调用,之前提到过,lambda是个对象,在写的时候就是在定义它,定义还没有定义好怎么能递归呢?
所以.递归是不可以的.
6.3 lambda 表达式的应用
学习lambda表达式之前,我们的可调用对象就只有函数指针和仿函数.函数指针定义起来比较麻烦,再加上,C++里面是不推荐函数指针的.用仿函数又要去写一个类重载operatpor(),相比也比较麻烦.使用 lambda表示式既简单又方便,而且可读性还好.
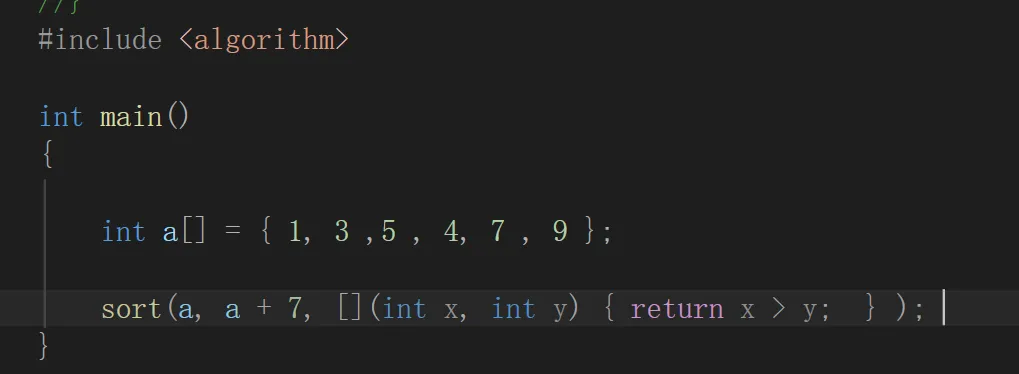
lambda表达式还有很多有用的地方,比如线程中的执行函数逻辑,智能指针中的定制删除器,还是很广泛的.
6.4 lambda 表达式的原理
lambda表达式的底层类似范围for,从底层看,根本没有lambda和范围for. 范围for底层是迭代器,lambda表达式底层就是仿函数对象.也就是说,我们写了一个lambda,底层就会生成一个仿函数对象.
这个仿函数的类名是有规则的,就是之前提到的lambda + uuid, 以保证类名的不同. lambda的参数,返回类型,函数体,就对应operator()的, 捕捉列表的本质是生成仿函数的成员变量.也就是说 捕捉列表里面的变量都是lambda类构造函数的实参.
我们可以从汇编层验证一下.
7. 包装器
7.1 function
std:: function 是一个类模板,也是一个包装器. std::function的实例对象可以包装任何可调用对象,包括函数指针,仿函数,lambda ,bind 表达式. 储存的可调用对象被称为std::function的目标.
若std::function不含目标,则称他为空,调用空的std::function目标会抛std::bad_function_call异常.
function 被定义在 <functional> 头文件中.
1 | template <class T> |
这个ret是返回值,args是参数包,这里用的比较奇怪,记住就好.
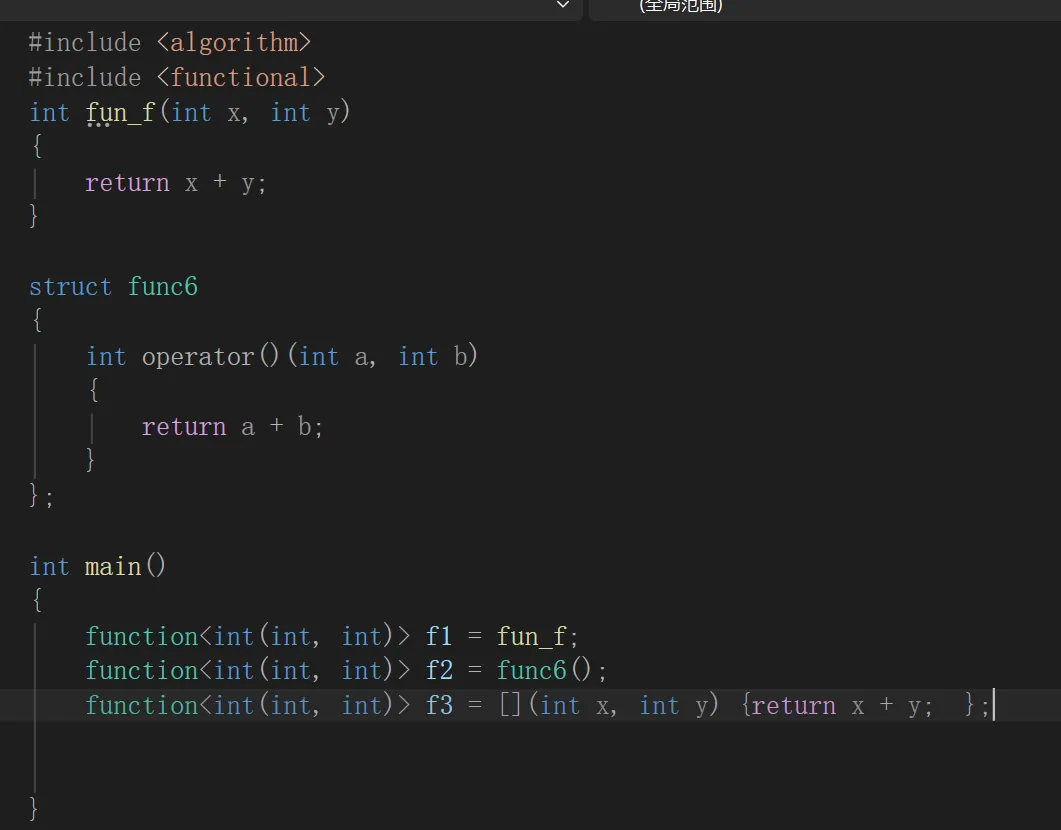
这里,leetcode上有一道题是逆波兰表达式求解.
[逆波兰表达式求值]150. 逆波兰表达式求值 - 力扣(LeetCode)
我简述一下思路吧,一般来说,是用一个栈来处理, 如果来的是 ‘+’ 执行 加法操作,如果是 ‘-‘就执行减法操作.一般的写法会用一个组if else或者switch case来解决,但是,有了包装器,
1 | map<string, function<int(int, int)>> opFuncMap = { |
调用的时候就这样
1 | for(auto& str : tokens) |
这样就可以实现一个字符串和函数的映射关系,更加的方便去维护
7.2 bind
bind 也是一个函数模板,它也是一个可调用对象的包装器,可以把它看成是一个函数适配器,对接受的可调用对象也返回一个可调用对象. 他的作用主要是两个,一个是可以调整参数顺序,一个是调整参数个数.我们更常用的是调整参数个数.
bind 也在 <functional> 中
1 | simple(1) |
调用bind的一般形式是:
1 | auto newcallcable = bind(callable, arg_list); |
其中,callable是一个可调用对象, arg_list是逗号隔开的参数列表,对应给定的 callable中的参数.
arg_list中可能包含形如_n的名字,其中 n 是一个整数,这些参数是占位符,表示对应的 newcallbale 中的参数,
_1 是第一个, _2 是第二个, 以此类推. 这些占位符在一个叫placeholder的命名空间中.
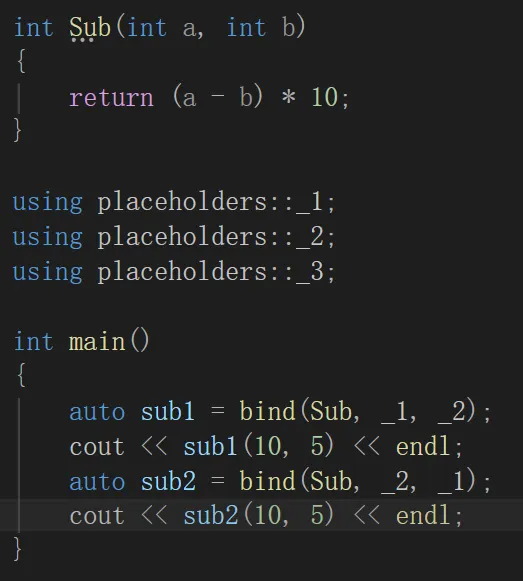
这是调整参数顺序,这个不常用.
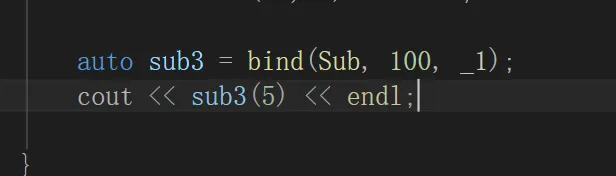
这是调整参数个数,这个常用,可以绑死一些参数. 比如计算复利的时候.