C++ 扩展学习知识 (一) 类型转换与 RTTI
C++ 扩展学习知识(一) 类型转换
1. C 语言中类型转换
在C语言中,某一些情况下比如说运算符左右两侧类型不同,或者说形参和实参类型不匹配等情况下都会发生或者说返回值和接受返回值的变量类型不匹配等场景,就需要发生类型转换。
C 语言中主要有两种类型转换,隐式类型转换和显示类型转换。
隐式类型转换:编译器在编译的时候自己去进行类型转换, 能转就转,不能转就报错,编译失败
隐式类型转换主要发生在一些有着较强关联性的类型之间,主要发生在整形和整形,比如之前提到过的整形提升之类的,还要整形和浮点型,浮点型和浮点型(单精度和双精度嘛)
要注意的是,虽然整形和浮点型在底层的存储方式是不一样的,依然是可以发生类型转换的,底层会自己去处理的我们在使用上不需要管。
1 | int i = 1; |
还有一种就是显示的类型转换,也就是用到我们的强制类型转换的操作符,这种的就是用户自己去用操作符去转换成指定类型。
一般我们在void* 指针转换的时候,或者指针转整形的时候,会用到显示的类型转换。
要注意的是,显示类型转换也是需要两个类型之间有一定的关系的,比如说不同的指针类型就是一个16进制的数字代表存储的位置也就是地址编号和管理大小,同样的整形也可以理解为空间的大小,所以指针和整形之间就可以进行强制的类型转换。
指针和指针更不用说,强转肯定没问题。
但相对的,指针和浮点数之间就不能进行类型转换,强转也不行,因为指针和浮点数是没有关系的,没有地址是个浮点数是不。
总结一句话呢就是类型转换一定是要发生在有一定关系的类型之中的。
2. C++ 中的类型转换
首先因为C++兼容C语言,所以C语言里面的类型转换C++都是支持的。这一部分是解决的内置类型和内置类型之间的类型转换。
我们知道C++面向对象的类型少不了自定义类型,内置类型转自定义类型换句话说就是调构造,因为我们说类型转换肯定是要有关系的之间才能转换,所以通过走构造函数也是合理。
那么自定义类型转内置类型呢?其实是要需要重载一个操作符来完成的。 那我们最先想到的就应该是这个 operator(), 因为强制类型转换用的这个嘛。但是很遗憾这个是不行的啊,因为这个已经有占用的了,一说仿函数大家估计就懂,这个()给了函数调用操作符,那C++这里咋办?
其实是特殊处理一下噢,还是重载这个()操作符,只不过这个要转换的类型不写在返回值的位置,这样写:
1 |
|
看到了吗?就是这个 operator int () ,通过这个函数呢就可以进行类型转换。
回想一下,我们在之前智能指针部分就提到过这里,shared_ptr 重载了 operator bool 可以隐式类型转换成 bool 值,直接用作判断这个智能指针有没有管理资源
还有一个比较重重要的点就是这个 explicit ,我们之前在讲初始化的时候讲过这个,加上这个初始化的时候就不支持自定义类型走构造到这个自定义类型的隐式类型转换类型转换了,但是显示类型转换依旧可以。
1 |
|
同样的,自定义类型转内置类型这个 operator int () 也是可以加上这个 explicit 的,代表的含义也是禁止隐式类型转换,可以显示类型转换的。
但是这里还有一个有趣的地方是什么呢?即使这个 shared_ptr 里面的这个类型转换成 bool 加了这个 explicit , 回想一下我们在 if while 使用的时候还是没有加这个强转也可以隐式的转。这里其实是发生了这个语境转换。
可以理解为是一个特殊处理,C++ 标准规定,在 if、while、for 的条件部分,或者逻辑非 ! 运算中,这种转换被视为显式语境。编译器认为你既然把它写在判断位,就是明确想把它当布尔值用。也就可以不加入这个explicit
除了内置类型和内置类型之间的转换,自定义类型和内置类型的转换,还有就是自定义类型和自定义类型之间的转换了。
自定义类型和自定义类型之间的转换同样是通过构造函数来实现的,因为有一定关系可以转换嘛。自定义类型 A 转 B 就需要一个形参是 B 的构造函数来支持。
这个也比较好理解:
1 | class B |
这个自定义类型转自定义类型的情况其实我们之前就遇到过这样的情况,在链表的时候,iterator 和 const_iterator
想不起来没关系,直接来看例子:
1 |
|
就是上面提到的问题,这个 const 迭代器不能赋值给普通迭代器是为什么?权限缩小和放大吗,绝对不是,权限缩小是仅限指针和引用之间的,这里的两个迭代器是两个类型的对象,而不是引用,仔细回想一下当时,我们在处理这两个迭代器的时候是用了一个相同的类模板实例化出来的不同的类,而不是指针和引用。
所以,这里的不能赋值就是因为这里是自定义类型转自定义之间的类型转换,没有相应的构造函数可以转换,
来看一下我们当时的实现方式:
1 |
|
可以看到我们在里面加入一个上面打注释的地方的一个构造函数就可以解决问题。
所以这个函数在这里有双重作用啊,加上这个函数就可以了,库里面是支持的,看看SGI源码的话也是有的但是好像被typedef了一下。
3. C++ 中的强制类型转换
3.1 类型安全
类型安全是指编程语⾔在编译和运⾏时提供保护机制,避免⾮法的类型转换和操作,导致出现⼀个内存访问错误等,从⽽减少程序运⾏时的错误。
C 和 C++ 都不是类型安全的,C++ 支持C 嘛,自然也就不是类型安全的。语⾔允许隐式类型转换,⼀些特殊情况下就会导致越界访问的内存错误,其次不合理的使⽤强制类型转换也会导致问题,⽐如⼀个 int* 的指针强转成 double* 访问就会出现越界。
1 | void insert(size_t pos, char ch) |
因此呢,C++ 提出了四个显示的命名强制类型转换 static_cast/ reinterpret_cast / const_cast / dynimic_cast 就是为了让这个类型转换相对而言更加的安全
3.2 C++ 中的四种显式强制类型转换
static_cast : static_cast 是用于两个意义相近的类型之间的类型进行类型转换,和隐式类型的转换的意思差不读,对应隐式类型转换,但是注意被转换的类型里面不要有 const 修饰的,要不然传不过去。
1 | double m = 1.23; |
注意是这样使用的奥,要转成什么< > 里面就是什么,然后有一个括号括起来操作数,这四个其实都相当于是操作符。
这里可以看到我们可以使用这歌 static_cast 来把左值给给右值引用, 其实 move 的底层就是使用了一共 static_cast 把左值转成了右值引用
reinterpret_cast : reinterpret_cast 是用于两个意义不相近的类型之间的转化,对象的就是强制类型转化,此时转换完成后数据解释的意义就会发生改变,(interpret 解释嘛 re 一下), 这样转换是一个比较激进的方式。这样转换以后是没有内存访问安全问题的, 举个例子就是我们整数和指针之间的类型的转换, 指针和指针之间的类型转换
1 | int* p= reinterpret_cast<int*>(a); |
const_cast 是用于 const 类型到非 const 类型的转换,去掉了 const 属性。
看着很简单,但其实有大坑奥,也是之前我们没有讲到的。其实,我们在没有这歌 const_cast 的时候,也可以去改变一个 const 对象的值,通过指针来间接访问就好:
1 | const int y = 0; |
就像这样,我们可以通过访问 y 的地址来间接去修改 y 的值。 但是真的修改吗?其实并没有。
当我们输出一下 y 和 *p 的时候,发现是不一样的 y 还是 0, *p 是 1。
为什么会这样呢?其实编译器在遇到 const 变量的时候会做一些特殊处理,因为 const 不能改嘛, 编译器会优化编译时把它放在寄存器里面,而不是普通的就是我们之前说的内存里面,有些编译器也会就直接把这个 y 当成一个宏替换,所以我们这样改了以后呢,其实是没有改到 y 的值的。
那怎么办呢?加一个 volatile 就好了:
1 | volatile const int y = 0; |
加上这个的意思就是告诉编译器,不要去进行那些有的没的,就直接把这个 y 的存储和其它的一样。这样我们再通过刚才这样指针的方式去 const 化的话就没有问题了,y 也会跟着改。
再说回来,const_cast 使用的时候,去 const 也会有这个情况发生,解决办法还是一样,注意就好。
dynamic_cast 是用于将基类的指针和引用转化为派生类的指针或引用,是一种向下转化。什么叫向下转化。这里我们来捋一下基类和派生类之间的转化:
首先,我们之前讲到过这个派生类的对象可以给给基类的对象,会发生我们之前说的切片,就只留下父类里面的对象。同样,基类的指针和引用呢也可以给给父类指针的和引用,这个是向上转换。这些都是我们之前提到过的。
那么基类的指针或者引用转派生类指针或者引用的向下转换呢?是可以安全发生的吗?不一定。
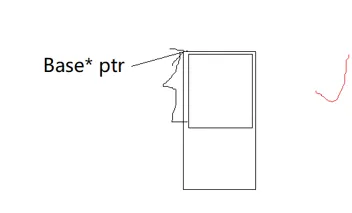
首先这个派生类指针转父类指针,那父类指针假设就管里面那个方块的大小,没什么问题。但是基类再转回派生类呢?
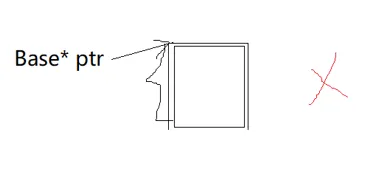
可以看到我们只有一个指向基类的指针,只知道基类的指针管理的大小,如果转成派生类指针的话,要怎么知道派生类指针要管多少个字节的大小的呢?是不是不知道啊,所以,这样转换然后再去访问的话就会发生越界访问的问题。
如果这个基类的指针本身就是指向一个派生类的话,那就没什么问题,但是第一种情况是个大坑。
这里的解决方式呢,就是这个 dynamic_cast , 这个操作符就是用来安全的来实现父类指针或者引用转派生类指针或者引用的这个向下转换的这个过程的。
如果我们转的这个父类指针是指向一个子类对象的,那他转出来就是安全的。如果是个指向基类的指针的的话,这个 dynamic_cast 会返回一个空指针,如果是俘虏引用的话就会抛这里的 bad_cast 异常。
其次呢,还有一个要注意的点就是 dynamic_cast 使用的对象必须要求是一个多态类型,也就是要有虚函数才能用奥。为什么呢?
这个就和他的原理有关系了。多态类型有虚函数,那他就有虚表,这个虚表附近,会存有一些其它的信息,比如说这个类的类型信息 type_info 当然这个具体在哪里的不确定的,根据编译器实现来的,C++只是规定了要有这个东西。
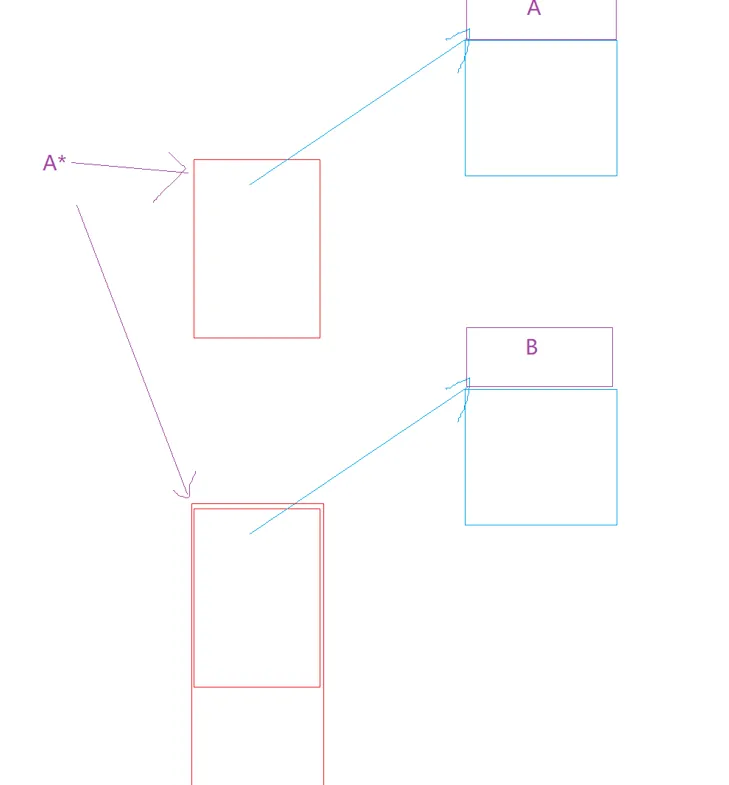
可以看到 A 类型的父类的,在这个虚表头上就存着 A类型的信息, B 就存 B类型的信息。当我们用这个 dynamic_cast 的时候,它里面就会那这个虚函数表的指针然后去看看这个类是父类还是子类,然后再出结果。
4. RTTI
我们之前讲过一个叫 RAII 这里的 RTTI ,没有关系啊,哈哈。
RTTI 呢在这个地方, 全程是 “Runtime Type Identification” ,即运行时类型识别。它指的是在运行的时候才知道对象的类型是什么,而不是在编译时。
RTTI 主要通过两个运算符来实现,dynameic_cast 和 typeid ; (准确的说的话是 typeid 的一部分情况)。别的类型其实编译器编译的时候都能看得见类型是什么。 dynamic_cast 我们之前已经讲过了,主要是用于把基类的指和引用安全转派生类的指针和引用。这里主要来讲这个 typeid.
typeid 主要用于返回表达式的类型,我们好久之前好像是讲 vector 的时候提到过。当时我们这么弄:
1 |
|
我们当时是通过这样的方式来看这个迭代器具体的类型是什么,vs下运行就会输出这个 iterator真实的那一长串类型,就是个字符串。
typeid() 里面可以是任意表达式,也可以是任意类型的名字。 他会返沪一个 typeinfo 或者 typeinfo 的派生类对象的引用,这样是为什么我们可以调出 .name() 这个函数。
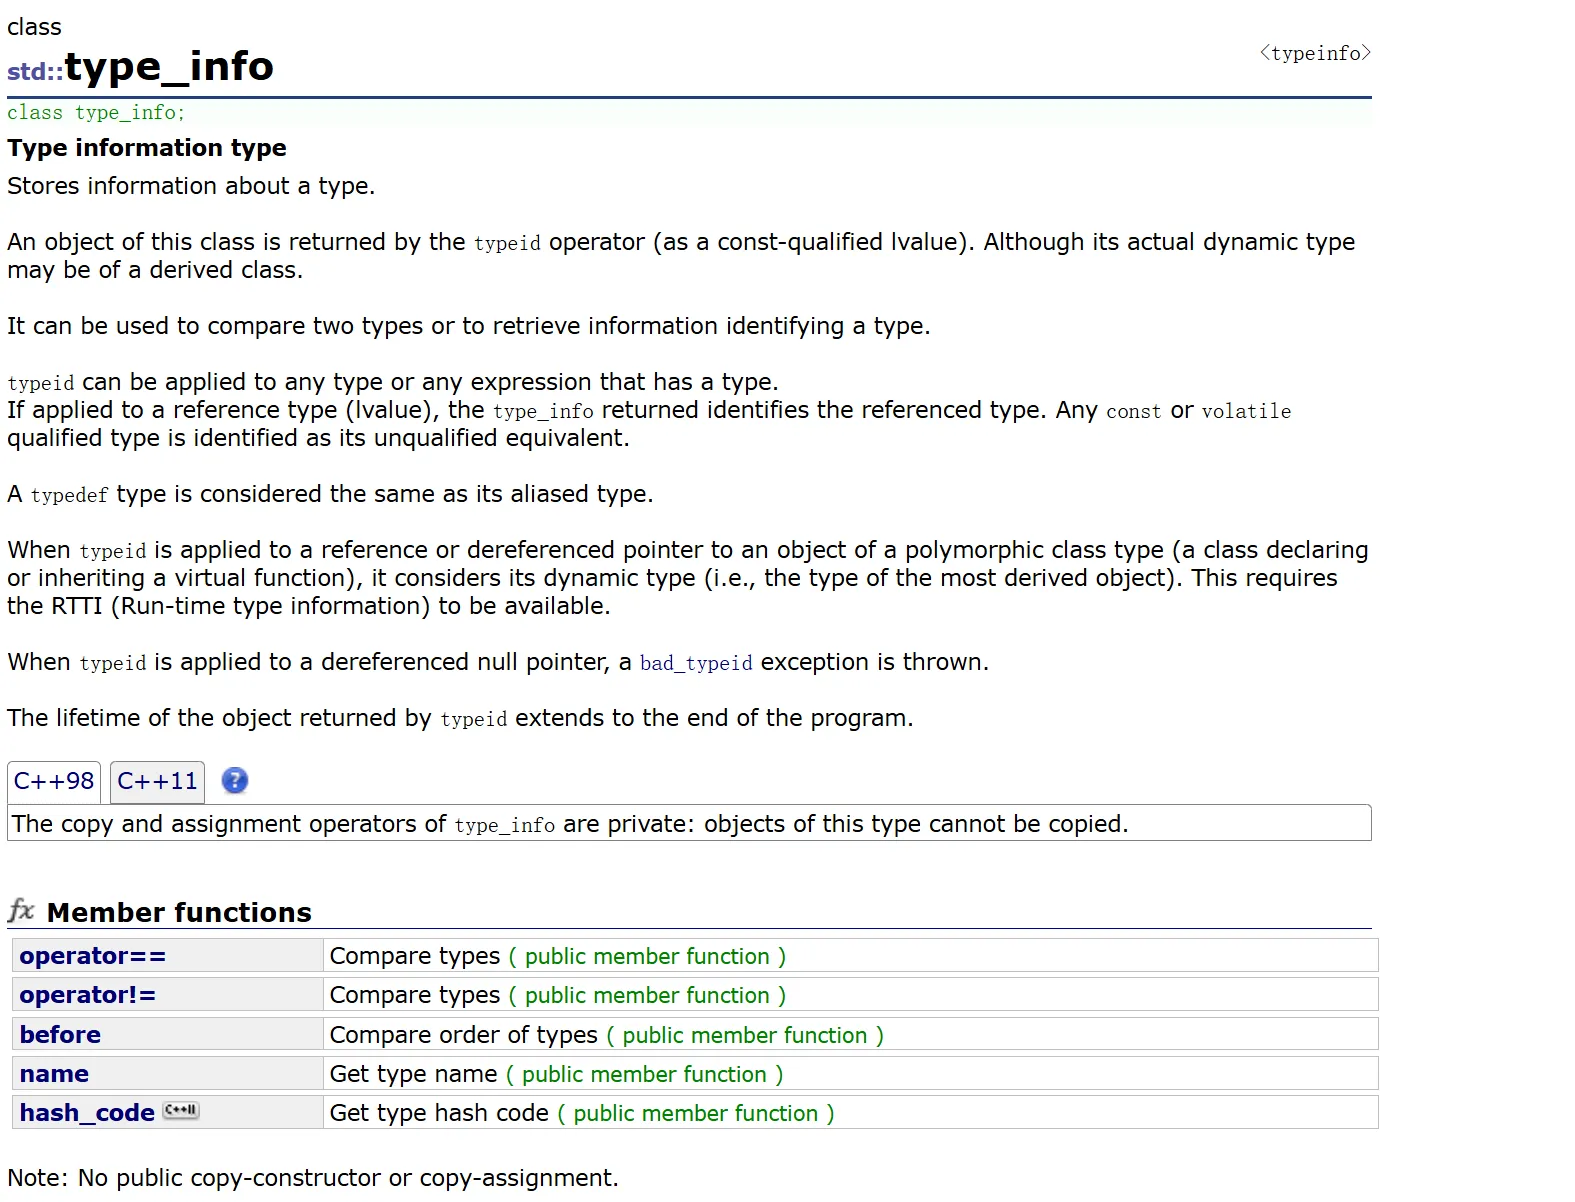
可以看到这个type_info 这个类里面呢,是重载了这里的 == 和 不等于 还有name,什么的,我们主要用到的就是这三个。 剩下的两个before是返回这个类型的顺序,还有hash_code是返回这个类型对应的这个哈希编号,我们用到的很少,感兴趣可以看看。
所以在这个地方,我们也就了解到了这个的 type_info 可比较相等或者不想等,这个好理解,两个类型想不想等嘛。还可以看这个类型的 name ,注意这个 name 是返回一个 C风格的字符串,也就是 cosnt char* 。
还需要注意的一个点呢就是不同的编译器下,typeinfo 的精确定义是略有差异的,也就意味着在这个 .name() 出来的类型名字是会有所不同的。这里的 .name() 出来的比如说这个 vs 下返回的是正常的这个迭代器的一大串原名,这个 gcc 里面返回的就是经过这个处理的奥,实话看着像乱码哈哈。
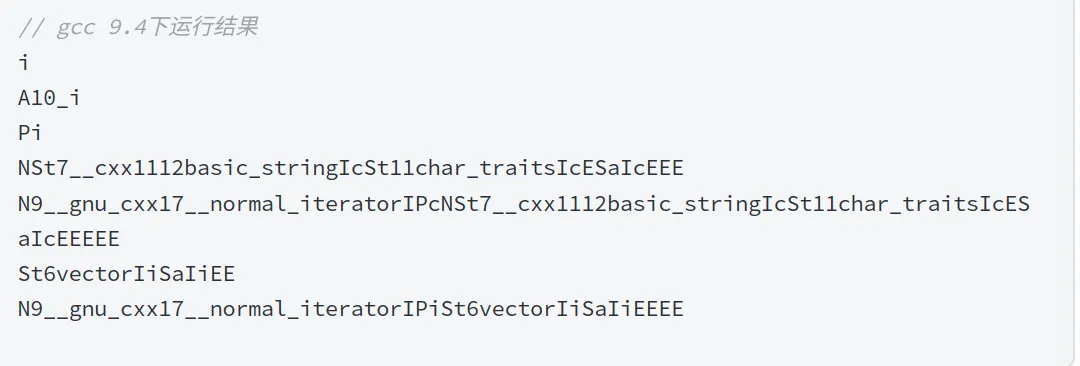
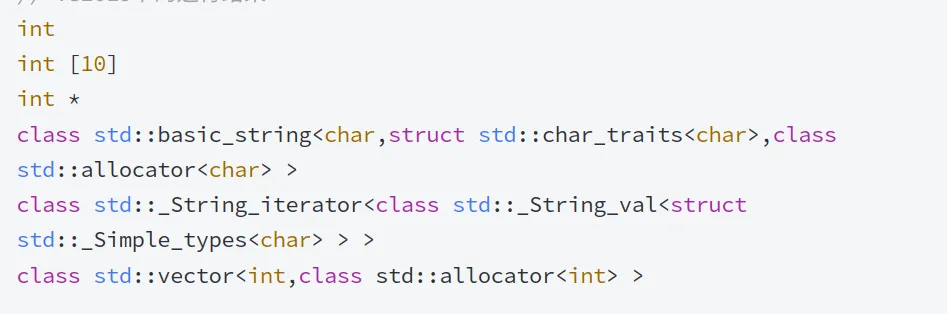
其实上述这个 typeid 的用法都不能算是 RTTI, 因为这些类型编译时就能确定,typeid 返回的其实是对象的静态类型。
typeid RTTI 的情况和这个 dynamic_cast 类似,是针对有虚函数的多态类型的。 当它的运算对象定义了至少一个多态类型的左值时,typeid 的返回值在运行时求得。
1 |
|
可以看到 typeid 也是可以用来检测父类指针指向的是父类还是子类,前提要是继承关系的多态类型,要不然会抛这个 bad_typeid
的异常。 可以看到下面的对比,pa 和 pb 是两个指针, typeid 求的并不是动态确定的,在编译时就确定的指针类型奥。
这个 typeid 的RTTI的底层方式和 dynamic_cast 是差不错的,都是直接看虚表里面的类型信息来判断的。
如果 typeid 的对象不是多态类型(没虚函数),它在编译时就确定了;如果对象是多态类型,它会去翻虚表(vtable)前面的 type_info,这才是真正的 RTTI。